LevelDB是Google开源的持久化KV单机数据库,具有很高的随机写,顺序读/写性能,但是随机读的性能很一般,也就是说,LevelDB很适合应用在查询较少,而写很多的场景。
一、设计理念
对于普通机械磁盘顺序写的性能要比随机写大很多。比如对于15000转的SAS盘,4K写IO, 顺序写在200MB/s左右,而随机写性能可能只有1MB/s左右。而LevelDB的设计思想正是利用了磁盘的这个特性。
LevelDB的数据是存储在磁盘上的,采用LSM算法进行处理。LSM算法将磁盘的随机写转化为顺序写,从而大大提高了写速度。为了做到这一点LSM的思路是将索引树结构拆成一大一小两颗树,较小的一个常驻内存,较大的一个持久化到磁盘,他们共同维护一个有序的key空间。写入操作会首先操作内存中的树,随着内存中树的不断变大,会触发与磁盘中树的归并操作,而归并操作本身仅有顺序写。如下图所示:
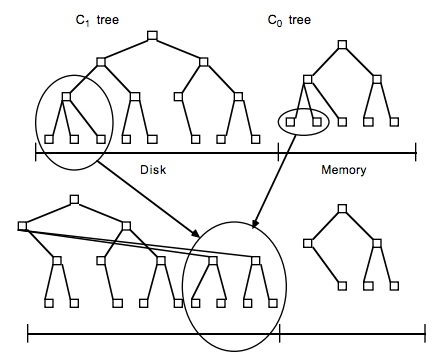 随着数据的不断写入,磁盘中的树会不断膨胀,为了避免每次参与归并操作的数据量过大,以及优化读操作的考虑,LevelDB将磁盘中的数据又拆分成多层,每一层的数据达到一定容量后会触发向下一层的归并操作,每一层的数据量比其上一层成倍增长。这也就是LevelDB的名称来源。
二、特点和局限性
特性:
- key和value都是任意长度的字节数组;
- entry(即一条K-V记录)默认是按照key的字典顺序存储的,当然开发者也可以重载这个排序函数;
- 提供的基本操作接口:Put()、Delete()、Get()、Batch();
- 支持批量操作以原子操作进行;
- 可以创建数据全景的snapshot(快照),并允许在快照中查找数据;
- 可以通过前向(或后向)迭代器遍历数据(迭代器会隐含的创建一个snapshot);
- 自动使用Snappy压缩数据;
- 可移植性; 限制:
- 非关系型数据模型(NoSQL),不支持sql语句,也不支持索引;
- 一次只允许一个进程访问一个特定的数据库;
- 没有内置的C/S架构,但开发者可以使用LevelDB库自己封装一个server;
三、整体结构
LevelDb本质上是一套存储系统以及在这套存储系统上提供的一些操作接口。包括六个主要部分:内存中的MemTable和Immutable MemTable以及磁盘上的几种主要文件:Current文件,Manifest文件,log文件以及SSTable文件。
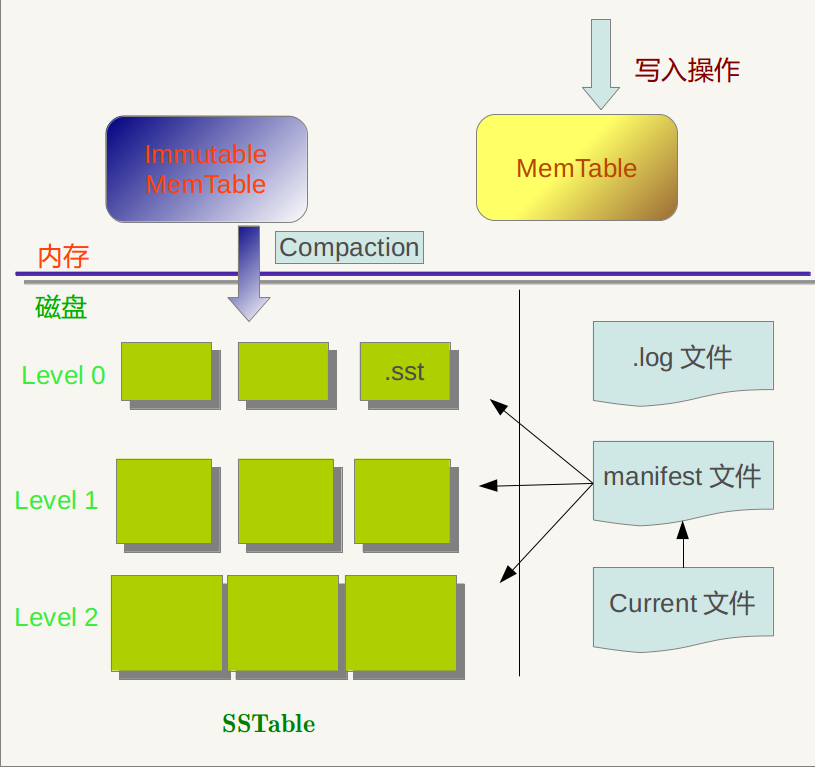
- Memtable:在内存中的KV数据,跳表实现,新的数据会首先写入这里,所以这是为何说LevelDb写入速度极快的主要原因;
- Log文件:写MemTable前会先写Log文件,Log通过append的方式顺序写入,使得机器宕机导致的内存数据丢失得以恢复;
- Immutable MemTable:达到MemTable设置的容量上限后,会生成新的Log文件和Memtable,原先的Memtable就成为Immutable Memtable,LevelDb后台调度会将Immutable Memtable的数据导出到磁盘,形成一个新的SSTable文件;
- SSTable文件:在磁盘中的KV数据(有序的),分为Level 0到Level N多层,每一层包含多个SST文件;单层SST文件总量随层次增加成倍增长;文件内数据有序;其中Level0的SST文件由Immutable直接Dump产生,其他Level的SST文件由其上一层的文件和本层文件归并产生;
- Manifest文件:记录SSTable信息,包括,属于哪个Level、最小key和最大key,以及其他一些LevelDB需要的元信息。
- Current文件: 在LevleDB的运行过程中,随着Compaction的进行,SST文件会发生变化,有新的文件产生,老的文件被废弃,Manifest也会跟着反映这种变化,此时往往会新生成Manifest文件来记载这种变化,而Current则用来指出当前的那个Manifest文件。
四、Log文件
LevelDb对于一个log文件,会把它切割成以32K为单位的物理Block,每次读取的单位以一个Block作为基本读取单位,从物理布局来讲,一个log文件就是由连续的32K大小Block构成的。
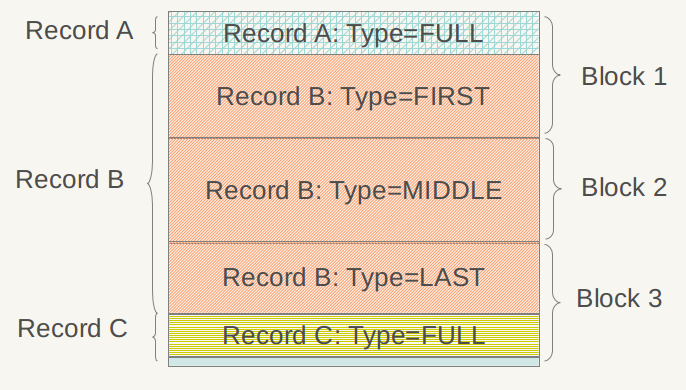 在应用的视野里是看不到这些Block的,应用看到的是一系列的Key:Value对,在LevelDb内部,会将一个Key:Value对看做一条记录的数据,另外在这个数据前增加一个记录头,用来记载一些管理信息,以方便内部处理。每一条记录由四个部分组成:
- CheckSum,即CRC验证码,占4个字节,是对“类型”和“数据”字段的校验码,为了避免处理不完整或者是被破坏的数据
- 记录长度,即数据部分的长度,2个字节
- 类型,这条记录的类型,1个字节
- 数据,就是这条记录的KV数据 “类型”字段指出了每条记录的逻辑结构和log文件物理分块结构之间的关系,具体而言,主要有以下四种类型:
- FULL,表示这是一条完整的记录,当前记录内容完整地存储在一个物理Block里,没有被不同的物理Block切割开
- FIRST,表示这是一条记录的第一部分
- MIDDLE,表示这是一条记录的中间部分
- LAST,表示这是一条记录的最后一部分
五、SSTable文件
LevelDb不同层级有很多SSTable文件(后缀.sst),所有.sst文件内部布局都是一样的。上节介绍Log文件是物理分块的,SSTable也一样会将文件划分为固定大小的物理存储块,但是两者逻辑布局大不相同,根本原因是:Log文件中的记录是Key无序的,即先后记录的key大小没有明确大小关系,而.sst文件内部则是根据记录的Key由小到大排列的,从下面介绍的SSTable布局可以体会到Key有序是为何如此设计.sst文件结构的关键。
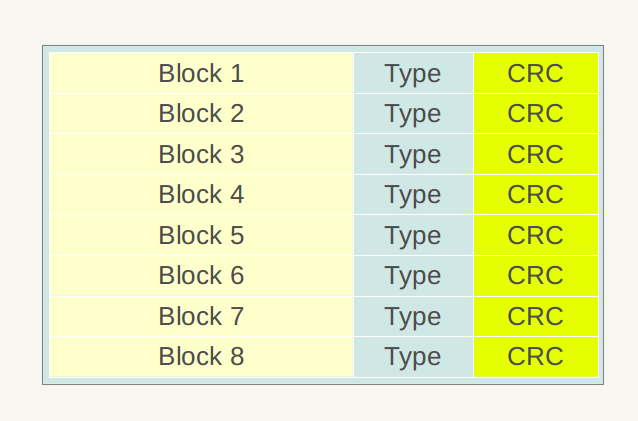 一个.sst文件的物理划分结构,同Log文件一样,也是划分为固定大小的存储块,每个Block分为三个部分,红色部分是数据存储区, 蓝色的Type区用于标识数据存储区是否采用了数据压缩算法(Snappy压缩或者无压缩两种),CRC部分则是数据校验码,用于判别数据是否在生成和传输中出错。
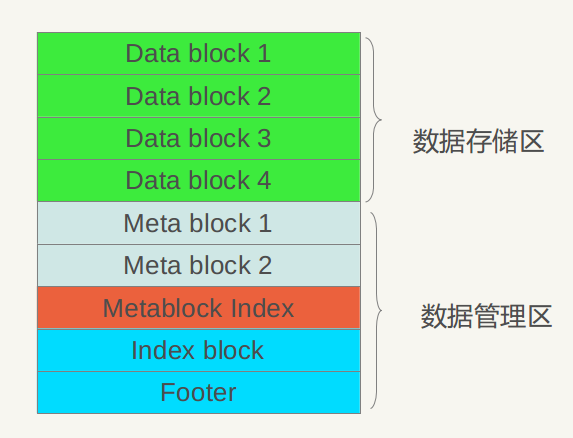 可以将sst文件划分为数据存储区和数据管理区,数据存储区存放实际的Key:Value数据,数据管理区则提供一些索引指针等管理数据,目的是更快速便捷的查找相应的记录。两个区域都是在上述的分块基础上的,就是说文件的前面若干块实际存储KV数据,后面数据管理区存储管理数据。管理数据又分为四种不同类型:紫色的Meta Block,红色的MetaBlock 索引和蓝色的数据索引块以及一个文件尾部块。
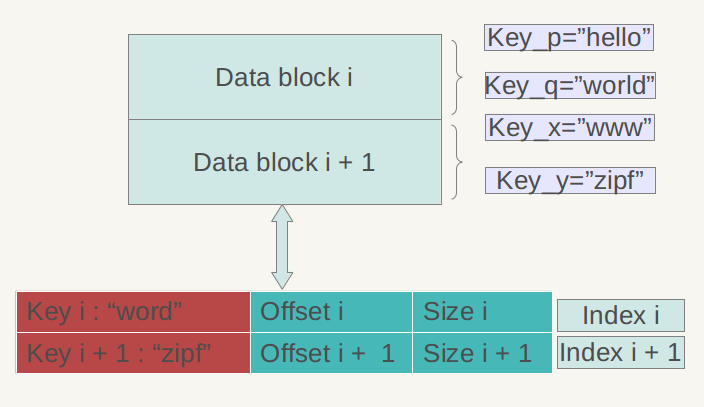 Data Block内的KV记录是按照Key由小到大排列的,数据索引区的每条记录是对某个Data Block建立的索引信息,每条索引信息包含三个内容,上图所示的数据块i的索引Index i来说:红色部分的第一个字段记载大于等于数据块i中最大的Key值的那个Key,第二个字段指出数据块i在.sst文件中的起始位置,第三个字段指出Data Block i的大小(有时候是有数据压缩的)。后面两个字段好理解,是用于定位数据块在文件中的位置的,第一个字段需要详细解释一下,在索引里保存的这个Key值未必一定是某条记录的Key,以图4.3的例子来说,假设数据块i 的最小Key=“samecity”,最大Key=“the best”;数据块i+1的最小Key=“the fox”,最大Key=“zoo”,那么对于数据块i的索引Index i来说,其第一个字段记载大于等于数据块i的最大Key(“the best”)同时要小于数据块i+1的最小Key(“the fox”),所以例子中Index i的第一个字段是:“the c”,这个是满足要求的;而Index i+1的第一个字段则是“zoo”,即数据块i+1的最大Key。
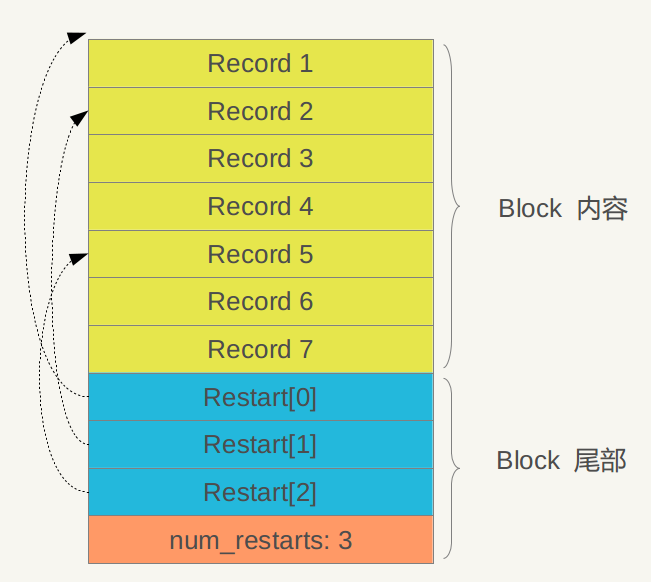 其内部也分为两个部分,前面是一个个KV记录,其顺序是根据Key值由小到大排列的,在Block尾部则是一些“重启点”(Restart Point),其实是一些指针,指出Block内容中的一些记录位置。
重启点”是干什么的呢?我们一再强调,Block内容里的KV记录是按照Key大小有序的,这样的话,相邻的两条记录很可能Key部分存在重叠,比如key i=“the Car”,Key i+1=“the color”,那么两者存在重叠部分“the c”,为了减少Key的存储量,Key i+1可以只存储和上一条Key不同的部分“olor”,两者的共同部分从Key i中可以获得。记录的Key在Block内容部分就是这么存储的,主要目的是减少存储开销。“重启点”的意思是:在这条记录开始,不再采取只记载不同的Key部分,而是重新记录所有的Key值,假设Key i+1是一个重启点,那么Key里面会完整存储“the color”,而不是采用简略的“olor”方式。Block尾部就是指出哪些记录是这些重启点的。
六、MemTable详解
LevelDb日知录前述小节大致讲述了磁盘文件相关的重要静态结构,本小节讲述内存中的数据结构Memtable,Memtable在整个体系中的重要地位也不言而喻。总体而言,所有KV数据都是存储在Memtable,Immutable Memtable和SSTable中的,Immutable Memtable从结构上讲和Memtable是完全一样的,区别仅仅在于其是只读的,不允许写入操作,而Memtable则是允许写入和读取的。当Memtable写入的数据占用内存到达指定数量,则自动转换为Immutable Memtable,等待Dump到磁盘中,系统会自动生成新的Memtable供写操作写入新数据,理解了Memtable,那么Immutable Memtable自然不在话下。 LevelDb的MemTable提供了将KV数据写入,删除以及读取KV记录的操作接口,但是事实上Memtable并不存在真正的删除操作,删除某个Key的Value在Memtable内是作为插入一条记录实施的,但是会打上一个Key的删除标记,真正的删除操作是Lazy的,会在以后的Compaction过程中去掉这个KV。 需要注意的是,LevelDb的Memtable中KV对是根据Key大小有序存储的,在系统插入新的KV时,LevelDb要把这个KV插到合适的位置上以保持这种Key有序性。其实,LevelDb的Memtable类只是一个接口类,真正的操作是通过背后的SkipList来做的,包括插入操作和读取操作等,所以Memtable的核心数据结构是一个SkipList(跳表)。 SkipList是平衡树的一种替代数据结构,但是和红黑树不相同的是,SkipList对于树的平衡的实现是基于一种随机化的算法的,这样也就是说SkipList的插入和删除的工作是比较简单的。 SkipList不仅是维护有序数据的一个简单实现,而且相比较平衡树来说,在插入数据的时候可以避免频繁的树节点调整操作,所以写入效率是很高的,LevelDb整体而言是个高写入系统,SkipList在其中应该也起到了很重要的作用。Redis为了加快插入操作,也使用了SkipList来作为内部实现数据结构。
七、写入与删除记录
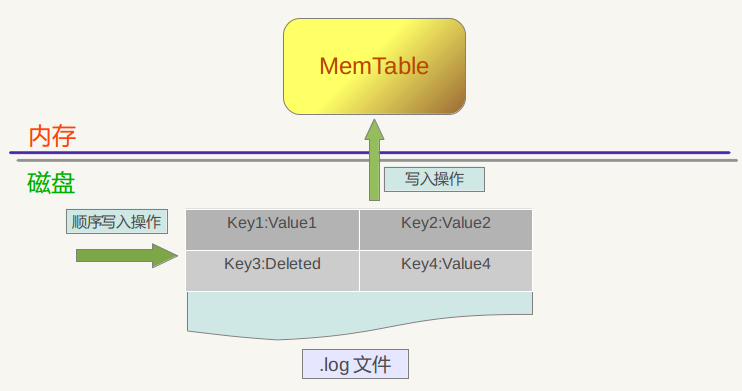 从图中可以看出,对于一个插入操作Put(Key,Value)来说,完成插入操作包含两个具体步骤:首先是将这条KV记录以顺序写的方式追加到之前介绍过的log文件末尾,因为尽管这是一个磁盘读写操作,但是文件的顺序追加写入效率是很高的,所以并不会导致写入速度的降低;第二个步骤是:如果写入log文件成功,那么将这条KV记录插入内存中的Memtable中,前面介绍过,Memtable只是一层封装,其内部其实是一个Key有序的SkipList列表,插入一条新记录的过程也很简单,即先查找合适的插入位置,然后修改相应的链接指针将新记录插入即可。完成这一步,写入记录就算完成了,所以一个插入记录操作涉及一次磁盘文件追加写和内存SkipList插入操作,这是为何levelDb写入速度如此高效的根本原因。
从上面的介绍过程中也可以看出:log文件内是key无序的,而Memtable中是key有序的。那么如果是删除一条KV记录呢?对于levelDb来说,并不存在立即删除的操作,而是与插入操作相同的,区别是,插入操作插入的是Key:Value 值,而删除操作插入的是“Key:删除标记”,并不真正去删除记录,而是后台Compaction的时候才去做真正的删除操作。
八、读取记录
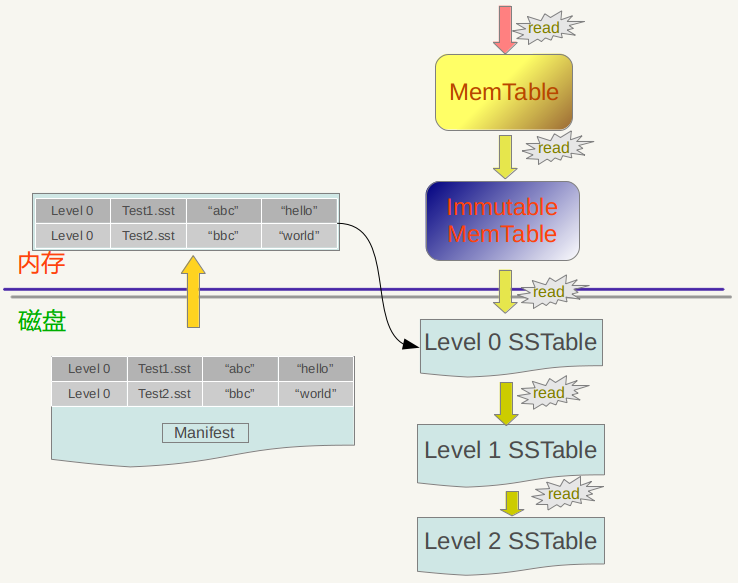 LevelDb首先会去查看内存中的Memtable,如果Memtable中包含key及其对应的value,则返回value值即可;如果在Memtable没有读到key,则接下来到同样处于内存中的Immutable Memtable中去读取,类似地,如果读到就返回,若是没有读到,那么只能万般无奈下从磁盘中的大量SSTable文件中查找。因为SSTable数量较多,而且分成多个Level,所以在SSTable中读数据是相当蜿蜒曲折的一段旅程。总的读取原则是这样的:首先从属于level 0的文件中查找,如果找到则返回对应的value值,如果没有找到那么到level 1中的文件中去找,如此循环往复,直到在某层SSTable文件中找到这个key对应的value为止(或者查到最高level,查找失败,说明整个系统中不存在这个Key)。
那么为什么是从Memtable到Immutable Memtable,再从Immutable Memtable到文件,而文件中为何是从低level到高level这么一个查询路径呢?道理何在?之所以选择这么个查询路径,是因为从信息的更新时间来说,很明显Memtable存储的是最新鲜的KV对;Immutable Memtable中存储的KV数据对的新鲜程度次之;而所有SSTable文件中的KV数据新鲜程度一定不如内存中的Memtable和Immutable Memtable的。对于SSTable文件来说,如果同时在level L和Level L+1找到同一个key,level L的信息一定比level L+1的要新。也就是说,上面列出的查找路径就是按照数据新鲜程度排列出来的,越新鲜的越先查找。
为啥要优先查找新鲜的数据呢?这个道理不言而喻,举个例子。比如我们先往levelDb里面插入一条数据 {key="www.samecity.com" value="我们"},过了几天,samecity网站改名为:69同城,此时我们插入数据{key="www.samecity.com" value="69同城"},同样的key,不同的value;逻辑上理解好像levelDb中只有一个存储记录,即第二个记录,但是在levelDb中很可能存在两条记录,即上面的两个记录都在levelDb中存储了,此时如果用户查询key="www.samecity.com",我们当然希望找到最新的更新记录,也就是第二个记录返回,这就是为何要优先查找新鲜数据的原因。
前文有讲:对于SSTable文件来说,如果同时在level L和Level L+1找到同一个key,level L的信息一定比level L+1的要新。这是一个结论,理论上需要一个证明过程,否则会招致如下的问题:为神马呢?从道理上讲呢,很明白:因为Level L+1的数据不是从石头缝里蹦出来的,也不是做梦梦到的,那它是从哪里来的?Level L+1的数据是从Level L 经过Compaction后得到的(如果您不知道什么是Compaction,那么........也许以后会知道的),也就是说,您看到的现在的Level L+1层的SSTable数据是从原来的Level L中来的,现在的Level L比原来的Level L数据要新鲜,所以可证,现在的Level L比现在的Level L+1的数据要新鲜。
SSTable文件很多,如何快速地找到key对应的value值?在LevelDb中,level 0一直都爱搞特殊化,在level 0和其它level中查找某个key的过程是不一样的。因为level 0下的不同文件可能key的范围有重叠,某个要查询的key有可能多个文件都包含,这样的话LevelDb的策略是先找出level 0中哪些文件包含这个key(manifest文件中记载了level和对应的文件及文件里key的范围信息,LevelDb在内存中保留这种映射表), 之后按照文件的新鲜程度排序,新的文件排在前面,之后依次查找,读出key对应的value。而如果是非level 0的话,因为这个level的文件之间key是不重叠的,所以只从一个文件就可以找到key对应的value。
最后一个问题,如果给定一个要查询的key和某个key range包含这个key的SSTable文件,那么levelDb是如何进行具体查找过程的呢?levelDb一般会先在内存中的Cache中查找是否包含这个文件的缓存记录,如果包含,则从缓存中读取;如果不包含,则打开SSTable文件,同时将这个文件的索引部分加载到内存中并放入Cache中。 这样Cache里面就有了这个SSTable的缓存项,但是只有索引部分在内存中,之后levelDb根据索引可以定位到哪个内容Block会包含这条key,从文件中读出这个Block的内容,在根据记录一一比较,如果找到则返回结果,如果没有找到,那么说明这个level的SSTable文件并不包含这个key,所以到下一级别的SSTable中去查找。
九、Compaction
为了提升性能,LevelDb采取了compaction的方式来对已有的记录进行整理压缩,通过这种方式,来删除掉一些不再有效的KV数据,减小数据规模,减少文件数量等。
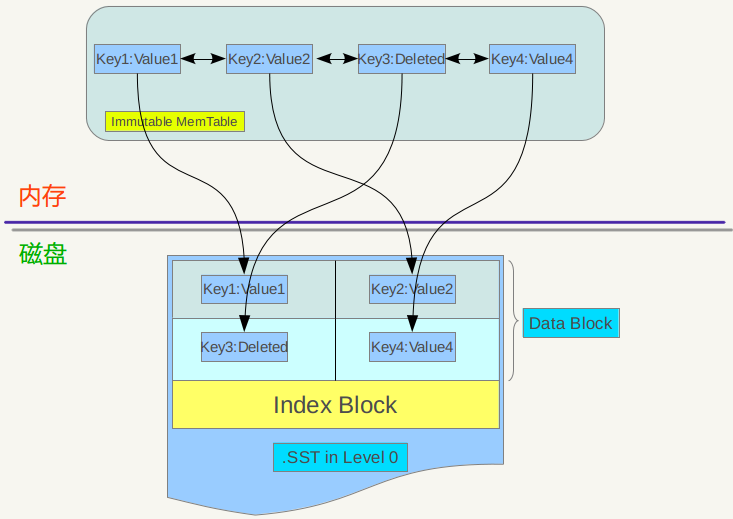 当内存中的memtable大小到了一定值时进行minor compaction操作,将数据保存到磁盘文件中,memtable会转换为immutable memtable,此时不能往其中写入记录,只能从中读取KV内容。之前介绍过,immutable memtable其实是一个多层级队列SkipList,其中的记录是根据key有序排列的。按照immutable memtable中记录由小到大遍历,并依次写入一个level 0 的新建SSTable文件中,写完后建立文件的index 数据。对于被删除的记录,compaction过程中并不真正删除这个记录,原因也很简单,这里只知道要删掉key记录,但是这个KV数据在哪里?那需要复杂的查找,所以在minor compaction的时候并不做删除,只是将这个key作为一个记录写入文件中,至于真正的删除操作,在以后更高层级的compaction中会去做。
当某个level下的SSTable文件数目超过一定设置值后,levelDb会从这个level的SSTable中选择一个文件(level>0),将其和高一层级的level+1的SSTable文件合并,这就是major compaction。
我们知道在大于0的层级中,每个SSTable文件内的Key都是由小到大有序存储的,而且不同文件之间的key范围(文件内最小key和最大key之间)不会有任何重叠。Level 0的SSTable文件有些特殊,尽管每个文件也是根据Key由小到大排列,但是因为level 0的文件是通过minor compaction直接生成的,所以任意两个level 0下的两个sstable文件可能再key范围上有重叠。所以在做major compaction的时候,对于大于level 0的层级,选择其中一个文件就行,但是对于level 0来说,指定某个文件后,本level中很可能有其他SSTable文件的key范围和这个文件有重叠,这种情况下,要找出所有有重叠的文件和level 1的文件进行合并,即level 0在进行文件选择的时候,可能会有多个文件参与major compaction。
levelDb在选定某个level进行compaction后,还要选择是具体哪个文件要进行compaction,levelDb在这里有个小技巧, 就是说轮流来,比如这次是文件A进行compaction,那么下次就是在key range上紧挨着文件A的文件B进行compaction,这样每个文件都会有机会轮流和高层的level 文件进行合并。
如果选好了level L的文件A和level L+1层的文件进行合并,那么问题又来了,应该选择level L+1哪些文件进行合并?levelDb选择L+1层中和文件A在key range上有重叠的所有文件来和文件A进行合并。
也就是说,选定了level L的文件A,之后在level L+1中找到了所有需要合并的文件B,C,D…..等等。剩下的问题就是具体是如何进行major 合并的?就是说给定了一系列文件,每个文件内部是key有序的,如何对这些文件进行合并,使得新生成的文件仍然Key有序,同时抛掉哪些不再有价值的KV 数据。
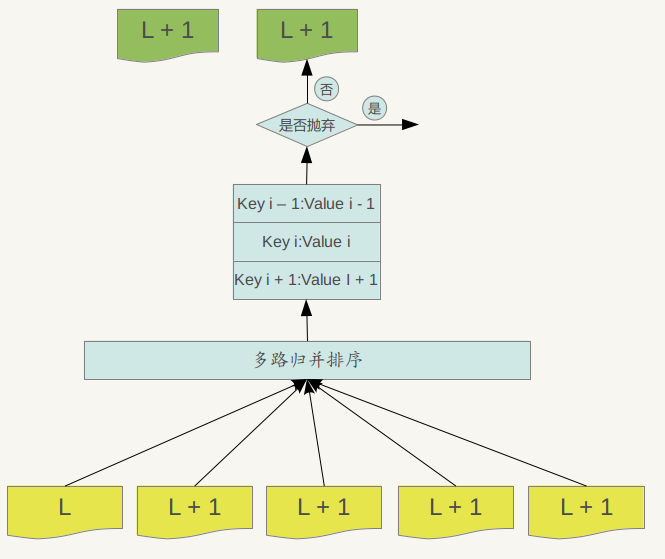 Major compaction的过程如下:对多个文件采用多路归并排序的方式,依次找出其中最小的Key记录,也就是对多个文件中的所有记录重新进行排序。之后采取一定的标准判断这个Key是否还需要保存,如果判断没有保存价值,那么直接抛掉,如果觉得还需要继续保存,那么就将其写入level L+1层中新生成的一个SSTable文件中。就这样对KV数据一一处理,形成了一系列新的L+1层数据文件,之前的L层文件和L+1层参与compaction 的文件数据此时已经没有意义了,所以全部删除。这样就完成了L层和L+1层文件记录的合并过程。
那么在major compaction过程中,判断一个KV记录是否抛弃的标准是什么呢?其中一个标准是:对于某个key来说,如果在小于L层中存在这个Key,那么这个KV在major compaction过程中可以抛掉。因为我们前面分析过,对于层级低于L的文件中如果存在同一Key的记录,那么说明对于Key来说,有更新鲜的Value存在,那么过去的Value就等于没有意义了,所以可以删除。
十、版本控制
在 Leveldb 中,Version 就代表了一个版本,它包括当前磁盘及内存中的所有文件信息。在所有的 version 中,只有一个是 CURRENT(当前版本),其它都是历史版本。 当执行一次 compaction 或者 创建一个 Iterator 后,Leveldb 将在当前版本基础上创建一个新版本,当前版本就变成了历史版本。
VersionSet 是所有 Version 的集合,管理着所有存活的 Version。 VersionEdit 表示 Version 之间的变化,相当于 delta 增量,表示有增加了多少文件,删除了文件:
Version0 + VersionEdit --> Version1 Version0->Version1->Version2->Version3
VersionEdit 会保存到 MANIFEST 文件中,当做数据恢复时就会从 MANIFEST 文件中读出来重建数据。 Leveldb 的这种版本的控制,让我想到了双 buffer 切换,双 buffer 切换来自于图形学中,用于解决屏幕绘制时的闪屏问题,在服务器编程中也有用处。 比如我们的服务器上有一个字典库,每天我们需要更新这个字典库,我们可以新开一个 buffer,将新的字典库加载到这个新 buffer 中,等到加载完毕,将字典的指针指向新的字典库。 Leveldb 的 version 管理和双 buffer 切换类似,但是如果原 version 被某个 iterator 引用,那么这个 version 会一直保持,直到没有被任何一个 iterator 引用,此时就可以删除这个 version。