Go语言通过自带的一个叫CGO的工具来支持C语言函数调用,同时我们可以用Go语言导出C动态库接口给其它语言使用。一个简单的cgo程序:
package main

//#include <stdio.h>
import "C"

func main() {
    C.puts(C.CString("Hello, World\n"))
}
通过import "C"语句启用CGO特性,同时包含C语言的<stdio.h>头文件。然后通过CGO包的C.CString函数将Go语言字符串转为C语言字符串,最后调用CGO包的C.puts函数向标准输出窗口打印转换后的C字符串。
一、CGO基础
要使用CGO特性,需要安装C/C++构建工具链,在macOS和Linux下是要安装GCC,在windows下是需要安装MinGW工具。同时需要保证环境变量CGO_ENABLED被设置为1,这表示CGO是被启用的状态。在本地构建时CGO_ENABLED默认是启用的,当交叉构建时CGO默认是禁止的。比如要交叉构建ARM环境运行的Go程序,需要手工设置好C/C++交叉构建的工具链,同时开启CGO_ENABLED环境变量。然后通过import "C"语句启用CGO特性。
1、import "C"语句
如果在Go代码中出现了import "C"语句则表示使用了CGO特性,紧跟在这行语句前面的注释是一种特殊语法,里面包含的是正常的C语言代码。当确保CGO启用的情况下,还可以在当前目录中包含C/C++对应的源文件。
package main

/*
#include <stdio.h>

void printint(int v) {
    printf("printint: %d\n", v);
}
*/
import "C"

func main() {
    v := 42
    C.printint(C.int(v))
}
开头的注释中写了要调用的C函数和相关的头文件,头文件被include之后里面的所有的C语言元素都会被加入到”C”这个虚拟的包中。需要注意的是,
- import "C"导入语句需要单独一行,不能与其他包一同import;
- 向C函数传递参数需要直接转化成对应C语言类型传递,如上例中C.int(v)用于将一个Go中的int类型值强制类型转换转化为C语言中的int类型值
- Go是强类型语言,所以cgo中传递的参数类型必须与声明的类型完全一致,而且传递前必须用”C”中的转化函数转换成对应的C类型,不能直接传入Go中类型的变量。
- 通过虚拟的C包导入的C语言符号并不需要是大写字母开头,它们不受Go语言的导出规则约束。
- cgo将当前包引用的C语言符号都放到了虚拟的C包中,同时当前包依赖的其它Go语言包内部可能也通过cgo引入了相似的虚拟C包,但是不同的Go语言包引入的虚拟的C包之间的类型是不能通用的。这个约束对于要自己构造一些cgo辅助函数时有可能会造成一点的影响。
2、#cgo语句
在import "C"语句前的注释中可以通过#cgo语句设置编译阶段和链接阶段的相关参数。编译阶段的参数主要用于定义相关宏和指定头文件检索路径。链接阶段的参数主要是指定库文件检索路径和要链接的库文件。
// #cgo CFLAGS: -DPNG_DEBUG=1 -I./include
// #cgo LDFLAGS: -L/usr/local/lib -lpng
// #include <png.h>
import "C"
上面的代码中,CFLAGS部分,-D部分定义了宏PNG_DEBUG,值为1;-I定义了头文件包含的检索目录。LDFLAGS部分,-L指定了链接时库文件检索目录,-l指定了链接时需要链接png库。
因为C/C++遗留的问题,C头文件检索目录可以是相对目录,但是库文件检索目录则需要绝对路径。在库文件的检索目录中可以通过${SRCDIR}变量表示当前包目录的绝对路径:
// #cgo LDFLAGS: -L${SRCDIR}/libs -lfoo
上面的代码在链接时将被展开为:
// #cgo LDFLAGS: -L/go/src/foo/libs -lfoo
#cgo语句主要影响CFLAGS、CPPFLAGS、CXXFLAGS、FFLAGS和LDFLAGS几个编译器环境变量。LDFLAGS用于设置链接时的参数,除此之外的几个变量用于改变编译阶段的构建参数(CFLAGS用于针对C语言代码设置编译参数)。
对于在cgo环境混合使用C和C++的用户来说,可能有三种不同的编译选项:其中CFLAGS对应C语言特有的编译选项、CXXFLAGS对应是C++特有的编译选项、CPPFLAGS则对应C和C++共有的编译选项。但是在链接阶段,C和C++的链接选项是通用的,因此这个时候已经不再有C和C++语言的区别,它们的目标文件的类型是相同的。
#cgo指令还支持条件选择,当满足某个操作系统或某个CPU架构类型时后面的编译或链接选项生效。比如下面是分别针对windows和非windows下平台的编译和链接选项:
// #cgo windows CFLAGS: -DX86=1
// #cgo !windows LDFLAGS: -lm
其中在windows平台下,编译前会预定义X86宏为1;在非widnows平台下,在链接阶段会要求链接math数学库。 如果在不同的系统下cgo对应着不同的c代码,我们可以先使用#cgo指令定义不同的C语言的宏,然后通过宏来区分不同的代码:
package main

/*
#cgo windows CFLAGS: -DCGO_OS_WINDOWS=1
#cgo darwin CFLAGS: -DCGO_OS_DARWIN=1
#cgo linux CFLAGS: -DCGO_OS_LINUX=1

#if defined(CGO_OS_WINDOWS)
    const char* os = "windows";
#elif defined(CGO_OS_DARWIN)
    static const char* os = "darwin";
#elif defined(CGO_OS_LINUX)
    static const char* os = "linux";
#else
#    error(unknown os)
#endif
*/
import "C"

func main() {
    print(C.GoString(C.os))
}
这样我们就可以用C语言中常用的技术来处理不同平台之间的差异代码。
3、build tag条件编译
build tag是在Go或cgo环境下的C/C++文件开头的一种特殊的注释。条件编译类似于前面通过#cgo指令针对不同平台定义的宏,只有在对应平台的宏被定义之后才会构建对应的代码。但是通过#cgo指令定义宏有个限制,它只能是基于Go语言支持的windows、darwin和linux等已经支持的操作系统。如果我们希望定义一个DEBUG标志的宏,#cgo指令就无能为力了。而Go语言提供的build tag条件编译特性则可以简单做到。比如下面的源文件只有在设置debug构建标志时才会被构建:
// +build debug

package main

var buildMode = "debug"
可以用以下命令构建:
go build -tags="debug"
go build -tags="windows debug"
我们可以通过-tags命令行参数同时指定多个build标志,它们之间用空格分隔。当有多个build tag时,我们将多个标志通过逻辑操作的规则来组合使用。比如以下的构建标志表示只有在”linux/386“或”darwin平台下非cgo环境“才进行构建。
// +build linux,386 darwin,!cgo
其中linux,386中linux和386用逗号链接表示AND的意思;而linux,386和darwin,!cgo之间通过空白分割来表示OR的意思。
二、类型转换
最初CGO是为了达到方便从Go语言函数调用C语言函数(用C语言实现Go语言声明的函数)以复用C语言资源这一目的而出现的(因为C语言还会涉及回调函数,自然也会涉及到从C语言函数调用Go语言函数(用Go语言实现C语言声明的函数))。现在,它已经演变为C语言和Go语言双向通讯的桥梁。要想利用好CGO特性,自然需要了解此二语言类型之间的转换规则。
1、数值类型
在Go语言中访问C语言的符号时,一般是通过虚拟的“C”包访问,比如C.int对应C语言的int类型。有些C语言的类型是由多个关键字组成,但通过虚拟的“C”包访问C语言类型时名称部分不能有空格字符,比如unsigned int不能直接通过C.unsigned int访问。因此CGO为C语言的基础数值类型都提供了相应转换规则,比如C.uint对应C语言的unsigned int。 Go语言中数值类型和C语言数据类型基本上是相似的,以下是它们的对应关系表。
| C语言类型 | CGO类型 | Go语言类型 |
|---|---|---|
| char | C.char | byte |
| singed char | C.schar | int8 |
| unsigned char | C.uchar | uint8 |
| short | C.short | int16 |
| unsigned short | C.ushort | uint16 |
| int | C.int | int32 |
| unsigned int | C.uint | uint32 |
| long | C.long | int32 |
| unsigned long | C.ulong | uint32 |
| long long int | C.longlong | int64 |
| unsigned long long int | C.ulonglong | uint64 |
| float | C.float | float32 |
| double | C.double | float64 |
| size_t | C.size_t | uint |
虽然在C语言中int、short等类型没有明确定义内存大小,但是在CGO中它们的内存大小是确定的。在CGO中,C语言的int和long类型都是对应4个字节的内存大小,size_t类型可以当作Go语言uint无符号整数类型对待。 CGO中,虽然C语言的int固定为4字节的大小,但是Go语言自己的int和uint却在32位和64位系统下分别对应4个字节和8个字节大小。如果需要在C语言中访问Go语言的int类型,可以通过GoInt类型访问,GoInt类型在CGO工具生成的_cgo_export.h头文件中定义。其实在_cgo_export.h头文件中,每个基本的Go数值类型都定义了对应的C语言类型,它们一般都是以单词Go为前缀。下面是64位环境下,_cgo_export.h头文件生成的Go数值类型的定义,其中GoInt和GoUint类型分别对应GoInt64和GoUint64:
typedef signed char GoInt8;
typedef unsigned char GoUint8;
typedef short GoInt16;
typedef unsigned short GoUint16;
typedef int GoInt32;
typedef unsigned int GoUint32;
typedef long long GoInt64;
typedef unsigned long long GoUint64;
typedef GoInt64 GoInt;
typedef GoUint64 GoUint;
typedef float GoFloat32;
typedef double GoFloat64;
除了GoInt和GoUint之外,并不推荐直接访问GoInt32、GoInt64等类型。更好的做法是通过C语言的C99标准引入的<stdint.h>头文件。为了提高C语言的可移植性,在<stdint.h>文件中,不但每个数值类型都提供了明确内存大小,而且和Go语言的类型命名更加一致。Go语言类型<stdint.h>头文件类型对比如表所示。
|C语言类型 |CGO类型 |Go语言类型 |int8_t |C.int8_t |int8 |uint8_t |C.uint8_t |uint8 |int16_t |C.int16_t |int16 |uint16_t |C.uint16_t |uint16 |int32_t |C.int32_t |int32 |uint32_t |C.uint32_t |uint32 |int64_t |C.int64_t |int64 |uint64_t |C.uint64_t |uint64
如果C语言的类型是由多个关键字组成,则无法通过虚拟的“C”包直接访问(比如C语言的unsigned short不能直接通过C.unsigned short访问)。但是,在<stdint.h>中通过使用C语言的typedef关键字将unsigned short重新定义为uint16_t这样一个单词的类型后,我们就可以通过C.uint16_t访问原来的unsigned short类型了。对于比较复杂的C语言类型,推荐使用typedef关键字提供一个规则的类型命名,这样更利于在CGO中访问。
2、Go字符串和切片
在CGO生成的_cgo_export.h头文件中还会为Go语言的字符串、切片、字典、接口和管道等特有的数据类型生成对应的C语言类型:
typedef struct { const char *p; GoInt n; } GoString;
typedef void *GoMap;
typedef void *GoChan;
typedef struct { void *t; void *v; } GoInterface;
typedef struct { void *data; GoInt len; GoInt cap; } GoSlice;
不过需要注意的是,其中只有字符串和切片在CGO中有一定的使用价值,因为CGO为他们的某些GO语言版本的操作函数生成了C语言版本,因此二者可以在Go调用C语言函数时马上使用;而CGO并未针对其他的类型提供相关的辅助函数,且Go语言特有的内存模型导致我们无法保持这些由Go语言管理的内存指针,所以它们C语言环境并无使用的价值。 在导出的C语言函数中我们可以直接使用Go字符串和切片。假设有以下两个导出函数:
//export helloString
func helloString(s string) {}

//export helloSlice
func helloSlice(s []byte) {}
CGO生成的_cgo_export.h头文件会包含以下的函数声明:
extern void helloString(GoString p0);
extern void helloSlice(GoSlice p0);
不过需要注意的是,如果使用了GoString类型则会对_cgo_export.h头文件产生依赖,而这个头文件是动态输出的。 Go1.10针对Go字符串增加了一个_GoString_预定义类型,可以降低在cgo代码中可能对_cgo_export.h头文件产生的循环依赖的风险。我们可以调整helloString函数的C语言声明为:
extern void helloString(_GoString_ p0);
因为_GoString_是预定义类型,我们无法通过此类型直接访问字符串的长度和指针等信息。Go1.10同时也增加了以下两个函数用于获取字符串结构中的长度和指针信息:
size_t _GoStringLen(_GoString_ s);
const char *_GoStringPtr(_GoString_ s);
更严谨的做法是为C语言函数接口定义严格的头文件,然后基于稳定的头文件实现代码。
3、结构体、联合、枚举类型
C语言的结构体、联合、枚举类型不能作为匿名成员被嵌入到Go语言的结构体中。在Go语言中,我们可以通过C.struct_xxx来访问C语言中定义的struct xxx结构体类型。结构体的内存布局按照C语言的通用对齐规则,在32位Go语言环境C语言结构体也按照32位对齐规则,在64位Go语言环境按照64位的对齐规则。对于指定了特殊对齐规则的结构体,无法在CGO中访问。 结构体的简单用法如下:
/*
struct A {
    int i;
    float f;
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a.i)
    fmt.Println(a.f)
}
如果结构体的成员名字中碰巧是Go语言的关键字,可以通过在成员名开头添加下划线来访问:
/*
struct A {
    int type; // type 是 Go 语言的关键字
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a._type) // _type 对应 type
}
但是如果有2个成员:一个是以Go语言关键字命名,另一个刚好是以下划线和Go语言关键字命名,那么以Go语言关键字命名的成员将无法访问(被屏蔽):
/*
struct A {
    int   type;  // type 是 Go 语言的关键字
    float _type; // 将屏蔽CGO对 type 成员的访问
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a._type) // _type 对应 _type
}
C语言结构体中位字段对应的成员无法在Go语言中访问,如果需要操作位字段成员,需要通过在C语言中定义辅助函数来完成。对应零长数组的成员,无法在Go语言中直接访问数组的元素,但其中零长的数组成员所在位置的偏移量依然可以通过unsafe.Offsetof(a.arr)来访问。
/*
struct A {
    int   size: 10; // 位字段无法访问
    float arr[];    // 零长的数组也无法访问
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a.size) // 错误: 位字段无法访问
    fmt.Println(a.arr)  // 错误: 零长的数组也无法访问
}
在C语言中,我们无法直接访问Go语言定义的结构体类型。对于联合类型,我们可以通过C.union_xxx来访问C语言中定义的union xxx类型。但是Go语言中并不支持C语言联合类型,它们会被转为对应大小的字节数组。
/*
#include <stdint.h>

union B1 {
    int i;
    float f;
};

union B2 {
    int8_t i8;
    int64_t i64;
};
*/
import "C"
import "fmt"

func main() {
    var b1 C.union_B1;
    fmt.Printf("%T\n", b1) // [4]uint8

    var b2 C.union_B2;
    fmt.Printf("%T\n", b2) // [8]uint8
}
如果需要操作C语言的联合类型变量,一般有三种方法:第一种是在C语言中定义辅助函数;第二种是通过Go语言的"encoding/binary"手工解码成员(需要注意大端小端问题);第三种是使用unsafe包强制转型为对应类型(这是性能最好的方式)。下面展示通过unsafe包访问联合类型成员的方式:
/*
#include <stdint.h>

union B {
    int i;
    float f;
};
*/
import "C"
import "fmt"

func main() {
    var b C.union_B;
    fmt.Println("b.i:", *(*C.int)(unsafe.Pointer(&b)))
    fmt.Println("b.f:", *(*C.float)(unsafe.Pointer(&b)))
}
虽然unsafe包访问最简单、性能也最好,但是对于有嵌套联合类型的情况处理会导致问题复杂化。对于复杂的联合类型,推荐通过在C语言中定义辅助函数的方式处理。
对于枚举类型,我们可以通过C.enum_xxx来访问C语言中定义的enum xxx结构体类型。
/*
enum C {
    ONE,
    TWO,
};
*/
import "C"
import "fmt"

func main() {
    var c C.enum_C = C.TWO
    fmt.Println(c)
    fmt.Println(C.ONE)
    fmt.Println(C.TWO)
}
在C语言中,枚举类型底层对应int类型,支持负数类型的值。我们可以通过C.ONE、C.TWO等直接访问定义的枚举值。
4、数组、字符串和切片
在C语言中,数组名其实对应于一个指针,指向特定类型特定长度的一段内存,但是这个指针不能被修改;当把数组名传递给一个函数时,实际上传递的是数组第一个元素的地址。为了讨论方便,我们将一段特定长度的内存统称为数组。C语言的字符串是一个char类型的数组,字符串的长度需要根据表示结尾的NULL字符的位置确定。C语言中没有切片类型。 在Go语言中,数组是一种值类型,而且数组的长度是数组类型的一个部分。Go语言字符串对应一段长度确定的只读byte类型的内存。Go语言的切片则是一个简化版的动态数组。Go语言和C语言的数组、字符串和切片之间的相互转换可以简化为Go语言的切片和C语言中指向一定长度内存的指针之间的转换。CGO的C虚拟包提供了以下一组函数,用于Go语言和C语言之间数组和字符串的双向转换:
// Go string to C string
// The C string is allocated in the C heap using malloc.
// It is the caller's responsibility to arrange for it to be
// freed, such as by calling C.free (be sure to include stdlib.h
// if C.free is needed).
func C.CString(string) *C.char

// Go []byte slice to C array
// The C array is allocated in the C heap using malloc.
// It is the caller's responsibility to arrange for it to be
// freed, such as by calling C.free (be sure to include stdlib.h
// if C.free is needed).
func C.CBytes([]byte) unsafe.Pointer

// C string to Go string
func C.GoString(*C.char) string

// C data with explicit length to Go string
func C.GoStringN(*C.char, C.int) string

// C data with explicit length to Go []byte
func C.GoBytes(unsafe.Pointer, C.int) []byte
其中C.CString针对输入的Go字符串,克隆一个C语言格式的字符串;返回的字符串由C语言的malloc函数分配,不使用时需要通过C语言的free函数释放。C.CBytes函数的功能和C.CString类似,用于从输入的Go语言字节切片克隆一个C语言版本的字节数组,同样返回的数组需要在合适的时候释放。C.GoString用于将从NULL结尾的C语言字符串克隆一个Go语言字符串。C.GoStringN是另一个字符数组克隆函数。C.GoBytes用于从C语言数组,克隆一个Go语言字节切片。 该组辅助函数都是以克隆的方式运行。当Go语言字符串和切片向C语言转换时,克隆的内存由C语言的malloc函数分配,最终可以通过free函数释放。当C语言字符串或数组向Go语言转换时,克隆的内存由Go语言分配管理。通过该组转换函数,转换前和转换后的内存依然在各自的语言环境中,它们并没有跨越Go语言和C语言。克隆方式实现转换的优点是接口和内存管理都很简单,缺点是克隆需要分配新的内存和复制操作都会导致额外的开销。 在reflect包中有字符串和切片的定义:
type StringHeader struct {
    Data uintptr
    Len  int
}

type SliceHeader struct {
    Data uintptr
    Len  int
    Cap  int
}
如果不希望单独分配内存,可以在Go语言中直接访问C语言的内存空间:
/*
static char arr[10];
static char *s = "Hello";
*/
import "C"
import "fmt"

func main() {
    // 通过 reflect.SliceHeader 转换
    var arr0 []byte
    var arr0Hdr = (*reflect.SliceHeader)(unsafe.Pointer(&arr0))
    arr0Hdr.Data = uintptr(unsafe.Pointer(&C.arr[0]))
    arr0Hdr.Len = 10
    arr0Hdr.Cap = 10

    // 通过切片语法转换
    arr1 := (*[31]byte)(unsafe.Pointer(&C.arr[0]))[:10:10]

    var s0 string
    var s0Hdr = (*reflect.StringHeader)(unsafe.Pointer(&s0))
    s0Hdr.Data = uintptr(unsafe.Pointer(C.s))
    s0Hdr.Len = int(C.strlen(C.s))

    sLen := int(C.strlen(C.s))
    s1 := string((*[31]byte)(unsafe.Pointer(&C.s[0]))[:sLen:sLen])
}
因为Go语言的字符串是只读的,用户需要自己保证Go字符串在使用期间,底层对应的C字符串内容不会发生变化、内存不会被提前释放掉。 在CGO中,会为字符串和切片生成和上面结构对应的C语言版本的结构体:
typedef struct { const char *p; GoInt n; } GoString;
typedef struct { void *data; GoInt len; GoInt cap; } GoSlice;
在C语言中可以通过GoString和GoSlice来访问Go语言的字符串和切片。如果是Go语言中数组类型,可以将数组转为切片后再行转换。如果字符串或切片对应的底层内存空间由Go语言的运行时管理,那么在C语言中不能长时间保存Go内存对象。
5、指针间的转换
在C语言中,不同类型的指针是可以显式或隐式转换的,如果是隐式只是会在编译时给出一些警告信息。但是Go语言对于不同类型的转换非常严格,任何C语言中可能出现的警告信息在Go语言中都可能是错误!指针是C语言的灵魂,指针间的自由转换也是cgo代码中经常要解决的第一个重要的问题。 在Go语言中两个指针的类型完全一致则不需要转换可以直接通用。如果一个指针类型是用type命令在另一个指针类型基础之上构建的,换言之两个指针底层是相同完全结构的指针,那么我我们可以通过直接强制转换语法进行指针间的转换。但是cgo经常要面对的是2个完全不同类型的指针间的转换,原则上这种操作在纯Go语言代码是严格禁止的。 cgo存在的一个目的就是打破Go语言的禁止,恢复C语言应有的指针的自由转换和指针运算。以下代码演示了如何将X类型的指针转化为Y类型的指针:
var p *X
var q *Y

q = (*Y)(unsafe.Pointer(p)) // *X => *Y
p = (*X)(unsafe.Pointer(q)) // *Y => *X
为了实现X类型指针到Y类型指针的转换,我们需要借助unsafe.Pointer作为中间桥接类型实现不同类型指针之间的转换。unsafe.Pointer指针类型类似C语言中的void*类型的指针。下面是指针间的转换流程的示意图:
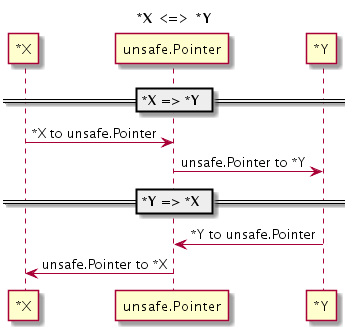
任何类型的指针都可以通过强制转换为unsafe.Pointer指针类型去掉原有的类型信息,然后再重新赋予新的指针类型而达到指针间的转换的目的。
6、数值和指针的转换
不同类型指针间的转换看似复杂,但是在cgo中已经算是比较简单的了。在C语言中经常遇到用普通数值表示指针的场景,也就是说如何实现数值和指针的转换也是cgo需要面对的一个问题
为了严格控制指针的使用,Go语言禁止将数值类型直接转为指针类型!不过,Go语言针对unsafe.Pointr指针类型特别定义了一个uintptr类型。我们可以uintptr为中介,实现数值类型到unsafe.Pointr指针类型到转换。再结合前面提到的方法,就可以实现数值和指针的转换了。下面流程图演示了如何实现int32类型到C语言的char*字符串指针类型的相互转换:
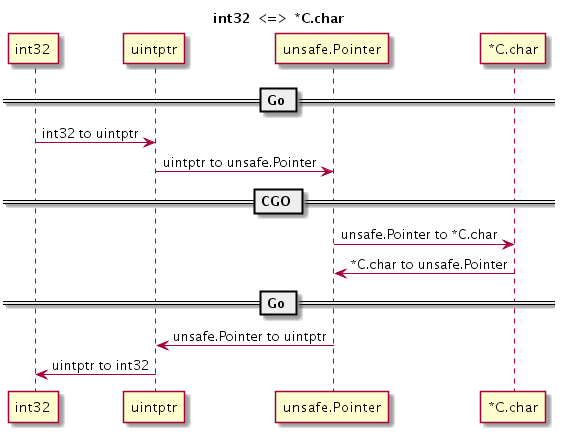
转换分为几个阶段:首先是int32到uintptr类型,然后是uintptr到unsafe.Pointr指针类型,最后是unsafe.Pointr指针类型到*C.char类型。
7、切片间的转换
在C语言中数组也一种指针,因此两个不同类型数组之间的转换和指针间转换基本类似。但是在Go语言中,数组或数组对应的切片都不再是指针类型,因此我们也就无法直接实现不同类型的切片之间的转换。不过Go语言的reflect包提供了切片类型的底层结构,再结合前面讨论到不同类型之间的指针转换技术就可以实现[]X和[]Y类型的切片转换:
var p []X
var q []Y

pHdr := (*reflect.SliceHeader)(unsafe.Pointer(&p))
qHdr := (*reflect.SliceHeader)(unsafe.Pointer(&q))

pHdr.Data = qHdr.Data
pHdr.Len = qHdr.Len * unsafe.Sizeof(q[0]) / unsafe.Sizeof(p[0])
pHdr.Cap = qHdr.Cap * unsafe.Sizeof(q[0]) / unsafe.Sizeof(p[0])
不同切片类型之间转换的思路是先构造一个空的目标切片,然后用原有的切片底层数据填充目标切片。如果X和Y类型的大小不同,需要重新设置Len和Cap属性。需要注意的是,如果X或Y是空类型,上述代码中可能导致除0错误,实际代码需要根据情况酌情处理。下面演示了切片间的转换的具体流程:
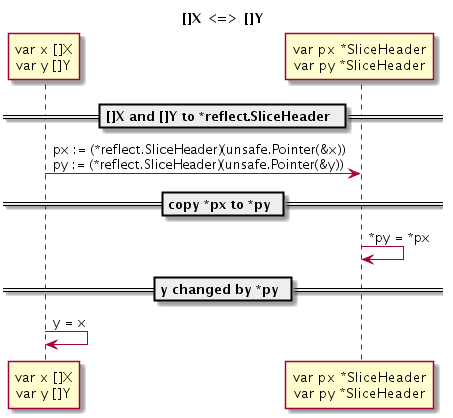
三、函数调用
函数是C语言编程的核心,通过CGO技术我们不仅仅可以在Go语言中调用C语言函数,也可以将Go语言函数导出为C语言函数。
1、Go调用C函数
对于一个启用CGO特性的程序,CGO会构造一个虚拟的C包。通过这个虚拟的C包可以调用C语言函数。
/*
static int add(int a, int b) {
    return a+b;
}
*/
import "C"

func main() {
    C.add(1, 1)
}
以上的CGO代码首先定义了一个当前文件内可见的add函数,然后通过C.add。
2、C函数的返回值
对于有返回值的C函数,我们可以正常获取返回值。
/*
static int div(int a, int b) {
    return a/b;
}
*/
import "C"
import "fmt"

func main() {
    v := C.div(6, 3)
    fmt.Println(v)
}
上面的div函数实现了一个整数除法的运算,然后通过返回值返回除法的结果。不过对于除数为0的情形并没有做特殊处理。如果希望在除数为0的时候返回一个错误,其他时候返回正常的结果。因为C语言不支持返回多个结果,因此<errno.h>标准库提供了一个errno宏用于返回错误状态。我们可以近似地将errno看成一个线程安全的全局变量,可以用于记录最近一次错误的状态码。改进后的div函数实现如下:
#include <errno.h>

int div(int a, int b) {
    if(b == 0) {
        errno = EINVAL;
        return 0;
    }
    return a/b;
}
CGO也针对<errno.h>标准库的errno宏做的特殊支持:在CGO调用C函数时如果有两个返回值,那么第二个返回值将对应errno错误状态。
/*
#include <errno.h>

static int div(int a, int b) {
    if(b == 0) {
        errno = EINVAL;
        return 0;
    }
    return a/b;
}
*/
import "C"
import "fmt"

func main() {
    v0, err0 := C.div(2, 1)
    fmt.Println(v0, err0)

    v1, err1 := C.div(1, 0)
    fmt.Println(v1, err1)
}
运行这个代码将会产生以下输出:
2 <nil>
0 invalid argument
我们可以近似地将div函数看作为以下类型的函数:
func C.div(a, b C.int) (C.int, [error])
第二个返回值是可忽略的error接口类型,底层对应syscall.Errno错误类型。
3、void函数的返回值
C语言函数还有一种没有返回值类型的函数,用void表示返回值类型。一般情况下,我们无法获取void类型函数的返回值,因为没有返回值可以获取。前面的例子中提到,cgo对errno做了特殊处理,可以通过第二个返回值来获取C语言的错误状态。对于void类型函数,这个特性依然有效。以下的代码是获取没有返回值函数的错误状态码:
//static void noreturn() {}
import "C"
import "fmt"

func main() {
    _, err := C.noreturn()
    fmt.Println(err)
}
此时,我们忽略了第一个返回值,只获取第二个返回值对应的错误码。我们也可以尝试获取第一个返回值,它对应的是C语言的void对应的Go语言类型:
//static void noreturn() {}
import "C"
import "fmt"

func main() {
    v, _ := C.noreturn()
    fmt.Printf("%#v", v)
}
运行这个代码将会产生以下输出:
main._Ctype_void{}
我们可以看出C语言的void类型对应的是当前的main包中的_Ctype_void类型。其实也将C语言的noreturn函数看作是返回_Ctype_void类型的函数,这样就可以直接获取void类型函数的返回值:
//static void noreturn() {}
import "C"
import "fmt"

func main() {
    fmt.Println(C.noreturn())
}
运行这个代码将会产生以下输出:
[]
其实在CGO生成的代码中,_Ctype_void类型对应一个0长的数组类型[0]byte,因此fmt.Println输出的是一个表示空数值的方括弧。以上有效特性虽然看似有些无聊,但是通过这些例子我们可以精确掌握CGO代码的边界,可以从更深层次的设计的角度来思考产生这些奇怪特性的原因。
4、C调用Go导出函数
CGO还有一个强大的特性:将Go函数导出为C语言函数,通过CGO的//export指令将Go语言实现的函数导出为C语言函数。这样的话我们可以定义好C语言接口,然后通过Go语言实现。 下面是用Go语言实现的add函数:
import "C"

//export add
func add(a, b C.int) C.int {
    return a+b
}
add函数名以小写字母开头,对于Go语言来说是包内的私有函数。但是从C语言角度来看,导出的add函数是一个可全局访问的C语言函数。如果在两个不同的Go语言包内,都存在一个同名的要导出为C语言函数的add函数,那么在最终的链接阶段将会出现符号重名的问题。 CGO生成的_cgo_export.h文件回包含导出后的C语言函数的声明。我们可以在纯C源文件中包含_cgo_export.h文件来引用导出的add函数。如果希望在当前的CGO文件中马上使用导出的C语言add函数,则无法引用_cgo_export.h文件。因为_cgo_export.h文件的生成需要依赖当前文件可以正常构建,而如果当前文件内部循环依赖还未生成的_cgo_export.h文件将会导致cgo命令错误。
#include "_cgo_export.h"

void foo() {
    add(1, 1);
}
当导出C语言接口时,需要保证函数的参数和返回值类型都是C语言友好的类型,同时返回值不得直接或间接包含Go语言内存空间的指针。
四、封装qsort
qsort快速排序函数是C语言的高阶函数,支持用于自定义排序比较函数,可以对任意类型的数组进行排序。尝试基于C语言的qsort函数封装一个Go语言版本的qsort函数。
1、认识qsort函数
qsort快速排序函数有<stdlib.h>标准库提供,函数的声明如下:
void qsort(
    void* base, size_t num, size_t size,
    int (*cmp)(const void*, const void*)
);
其中base参数是要排序数组的首个元素的地址,num是数组中元素的个数,size是数组中每个元素的大小。最关键是cmp比较函数,用于对数组中任意两个元素进行排序。cmp排序函数的两个指针参数分别是要比较的两个元素的地址,如果第一个参数对应元素大于第二个参数对应的元素将返回结果大于0,如果两个元素相等则返回0,如果第一个元素小于第二个元素则返回结果小于0。 下面的例子是用C语言的qsort对一个int类型的数组进行排序:
#include <stdio.h>
#include <stdlib.h>

#define DIM(x) (sizeof(x)/sizeof((x)[0]))

static int cmp(const void* a, const void* b) {
    const int* pa = (int*)a;
    const int* pb = (int*)b;
    return *pa - *pb;
}

int main() {
    int values[] = { 42, 8, 109, 97, 23, 25 };
    int i;

    qsort(values, DIM(values), sizeof(values[0]), cmp);

    for(i = 0; i < DIM(values); i++) {
        printf ("%d ",values[i]);
    }
    return 0;
}
其中DIM(values)宏用于计算数组元素的个数,sizeof(values[0])用于计算数组元素的大小。 cmp是用于排序时比较两个元素大小的回调函数。为了避免对全局名字空间的污染,我们将cmp回调函数定义为仅当前文件内可访问的静态函数。
2、将qsort函数从Go包导出
为了方便Go语言的非CGO用户使用qsort函数,我们需要将C语言的qsort函数包装为一个外部可以访问的Go函数。用Go语言将qsort函数重新包装为qsort.Sort函数:
package qsort

//typedef int (*qsort_cmp_func_t)(const void* a, const void* b);
import "C"
import "unsafe"

func Sort(
    base unsafe.Pointer, num, size C.size_t,
    cmp C.qsort_cmp_func_t,
) {
    C.qsort(base, num, size, cmp)
}
因为CGO不好直接表达C语言的函数类型,因此在C语言空间将比较函数类型重新定义为一个qsort_cmp_func_t类型。虽然Sort函数已经导出了,但是对于qsort包之外的用户依然不能直接使用该函数——Sort函数的参数还包含了虚拟的C包提供的类型。在CGO的内部机制一节中我们已经提过,虚拟的C包下的任何名称其实都会被映射为包内的私有名字。比如C.size_t会被展开为_Ctype_size_t,C.qsort_cmp_func_t类型会被展开为_Ctype_qsort_cmp_func_t。 被CGO处理后的Sort函数的类型如下:
func Sort(
    base unsafe.Pointer, num, size _Ctype_size_t,
    cmp _Ctype_qsort_cmp_func_t,
)
这样将会导致包外部用于无法构造_Ctype_size_t和_Ctype_qsort_cmp_func_t类型的参数而无法使用Sort函数。因此,导出的Sort函数的参数和返回值要避免对虚拟C包的依赖。重新调整Sort函数的参数类型和实现如下:
/*
#include <stdlib.h>

typedef int (*qsort_cmp_func_t)(const void* a, const void* b);
*/
import "C"
import "unsafe"

type CompareFunc C.qsort_cmp_func_t

func Sort(base unsafe.Pointer, num, size int, cmp CompareFunc) {
    C.qsort(base, C.size_t(num), C.size_t(size), C.qsort_cmp_func_t(cmp))
}
我们将虚拟C包中的类型通过Go语言类型代替,在内部调用C函数时重新转型为C函数需要的类型。因此外部用户将不再依赖qsort包内的虚拟C包。以下代码展示的Sort函数的使用方式:
package main

//extern int go_qsort_compare(void* a, void* b);
import "C"

import (
    "fmt"
    "unsafe"

    qsort "."
)

//export go_qsort_compare
func go_qsort_compare(a, b unsafe.Pointer) C.int {
    pa, pb := (*C.int)(a), (*C.int)(b)
    return C.int(*pa - *pb)
}

func main() {
    values := []int32{42, 9, 101, 95, 27, 25}

    qsort.Sort(unsafe.Pointer(&values[0]),
        len(values), int(unsafe.Sizeof(values[0])),
        qsort.CompareFunc(C.go_qsort_compare),
    )
    fmt.Println(values)
}
为了使用Sort函数,我们需要将Go语言的切片取首地址、元素个数、元素大小等信息作为调用参数,同时还需要提供一个C语言规格的比较函数。 其中go_qsort_compare是用Go语言实现的,并导出到C语言空间的函数,用于qsort排序时的比较函数。目前已经实现了对C语言的qsort初步包装,并且可以通过包的方式被其它用户使用。但是qsort.Sort函数已经有很多不便使用之处:用户要提供C语言的比较函数,这对许多Go语言用户是一个挑战。需要改进qsort函数的包装函数,尝试通过闭包函数代替C语言的比较函数。消除用户对CGO代码的直接依赖。
3、改进:闭包函数作为比较函数
在改进之前我们先回顾下Go语言sort包自带的排序函数的接口:
func Slice(slice interface{}, less func(i, j int) bool)
标准库的sort.Slice因为支持通过闭包函数指定比较函数,对切片的排序非常简单:
import "sort"

func main() {
    values := []int32{42, 9, 101, 95, 27, 25}

    sort.Slice(values, func(i, j int) bool {
        return values[i] < values[j]
    })

    fmt.Println(values)
}
我们也尝试将C语言的qsort函数包装为以下格式的Go语言函数:
package qsort

func Sort(base unsafe.Pointer, num, size int, cmp func(a, b unsafe.Pointer) int)
闭包函数无法导出为C语言函数,因此无法直接将闭包函数传入C语言的qsort函数。为此我们可以用Go构造一个可以导出为C语言的代理函数,然后通过一个全局变量临时保存当前的闭包比较函数。
var go_qsort_compare_info struct {
    fn func(a, b unsafe.Pointer) int
    sync.Mutex
}

//export _cgo_qsort_compare
func _cgo_qsort_compare(a, b unsafe.Pointer) C.int {
    return C.int(go_qsort_compare_info.fn(a, b))
}
其中导出的C语言函数_cgo_qsort_compare是公用的qsort比较函数,内部通过go_qsort_compare_info.fn来调用当前的闭包比较函数。新的Sort包装函数实现如下:
/*
#include <stdlib.h>

typedef int (*qsort_cmp_func_t)(const void* a, const void* b);
extern int _cgo_qsort_compare(void* a, void* b);
*/
import "C"

func Sort(base unsafe.Pointer, num, size int, cmp func(a, b unsafe.Pointer) int) {
    go_qsort_compare_info.Lock()
    defer go_qsort_compare_info.Unlock()

    go_qsort_compare_info.fn = cmp

    C.qsort(base, C.size_t(num), C.size_t(size),
        C.qsort_cmp_func_t(C._cgo_qsort_compare),
    )
}
每次排序前,对全局的go_qsort_compare_info变量加锁,同时将当前的闭包函数保存到全局变量,然后调用C语言的qsort函数。基于新包装的函数,我们可以简化之前的排序代码:
func main() {
    values := []int32{42, 9, 101, 95, 27, 25}

    qsort.Sort(unsafe.Pointer(&values[0]), len(values), int(unsafe.Sizeof(values[0])),
        func(a, b unsafe.Pointer) int {
            pa, pb := (*int32)(a), (*int32)(b)
            return int(*pa - *pb)
        },
    )

    fmt.Println(values)
}
现在排序不再需要通过CGO实现C语言版本的比较函数了,可以传入Go语言闭包函数作为比较函数。 但是导入的排序函数依然依赖unsafe包,这是违背Go语言编程习惯的。
4、改进:消除用户对unsafe包的依赖
前一个版本的qsort.Sort包装函数已经比最初的C语言版本的qsort易用很多,但是依然保留了很多C语言底层数据结构的细节。 现在我们将继续改进包装函数,尝试消除对unsafe包的依赖,并实现一个类似标准库中sort.Slice的排序函数。新的包装函数声明如下:
package qsort

func Slice(slice interface{}, less func(a, b int) bool)
首先,我们将slice作为接口类型参数传入,这样可以适配不同的切片类型。然后切片的首个元素的地址、元素个数和元素大小可以通过reflect反射包从切片中获取。为了保存必要的排序上下文信息,我们需要在全局包变量增加要排序数组的地址、元素个数和元素大小等信息,比较函数改为less:
var go_qsort_compare_info struct {
    base     unsafe.Pointer
    elemnum  int
    elemsize int
    less     func(a, b int) bool
    sync.Mutex
}
同样比较函数需要根据元素指针、排序数组的开始地址和元素的大小计算出元素对应数组的索引下标, 然后根据less函数的比较结果返回qsort函数需要格式的比较结果。
//export _cgo_qsort_compare
func _cgo_qsort_compare(a, b unsafe.Pointer) C.int {
    var (
        // array memory is locked
        base     = uintptr(go_qsort_compare_info.base)
        elemsize = uintptr(go_qsort_compare_info.elemsize)
    )

    i := int((uintptr(a) - base) / elemsize)
    j := int((uintptr(b) - base) / elemsize)

    switch {
    case go_qsort_compare_info.less(i, j): // v[i] < v[j]
        return -1
    case go_qsort_compare_info.less(j, i): // v[i] > v[j]
        return +1
    default:
        return 0
    }
}
新的Slice函数的实现如下:
func Slice(slice interface{}, less func(a, b int) bool) {
    sv := reflect.ValueOf(slice)
    if sv.Kind() != reflect.Slice {
        panic(fmt.Sprintf("qsort called with non-slice value of type %T", slice))
    }
    if sv.Len() == 0 {
        return
    }

    go_qsort_compare_info.Lock()
    defer go_qsort_compare_info.Unlock()

    defer func() {
        go_qsort_compare_info.base = nil
        go_qsort_compare_info.elemnum = 0
        go_qsort_compare_info.elemsize = 0
        go_qsort_compare_info.less = nil
    }()

    // baseMem = unsafe.Pointer(sv.Index(0).Addr().Pointer())
    // baseMem maybe moved, so must saved after call C.fn
    go_qsort_compare_info.base = unsafe.Pointer(sv.Index(0).Addr().Pointer())
    go_qsort_compare_info.elemnum = sv.Len()
    go_qsort_compare_info.elemsize = int(sv.Type().Elem().Size())
    go_qsort_compare_info.less = less

    C.qsort(
        go_qsort_compare_info.base,
        C.size_t(go_qsort_compare_info.elemnum),
        C.size_t(go_qsort_compare_info.elemsize),
        C.qsort_cmp_func_t(C._cgo_qsort_compare),
    )
}
首先需要判断传入的接口类型必须是切片类型。然后通过反射获取qsort函数需要的切片信息,并调用C语言的qsort函数。基于新包装的函数我们可以采用和标准库相似的方式排序切片:
import (
    "fmt"

    qsort "."
)

func main() {
    values := []int64{42, 9, 101, 95, 27, 25}

    qsort.Slice(values, func(i, j int) bool {
        return values[i] < values[j]
    })

    fmt.Println(values)
}
为了避免在排序过程中,排序数组的上下文信息go_qsort_compare_info被修改,我们进行了全局加锁。因此目前版本的qsort.Slice函数是无法并发执行的。