一、简述
有时候我们需要判断一个元素是否在一个集合中。最直接的方法就是将集合中的元素存在计算机中,遇到一个新元素时,将它和集合中的元素直接比较即可。一般来讲,计算机中的集合是用哈希表来存储的。它的好处是快速准确,缺点是耗费存储空间。其根本原因是哈希表方法需要把实实在在的具有特定长度(每个Email地址对应成一个8字节的信息指纹)的元素的信息指纹存储在内存或硬盘中的哈希表中。比如每存储一亿个Email地址,需要0.8G大小的数字指纹存储空间,考虑到哈希表的存储空间利用率一般只有一半,所以需要1.6G的存储空间。如果存储几十亿上百亿的Email地址,那就需要百亿字节的内存存储空间。 布隆过滤器主要就是用于解决:快速判断一个元素是否在一个集合中,优势是只需要占用很小的内存空间以及有着高效的查询效率,缺点是不能从布隆过滤器中删除元素和有一定的误报率
二、原理
利用一个很长的二进制向量和一系列的随机映射函数来实现。
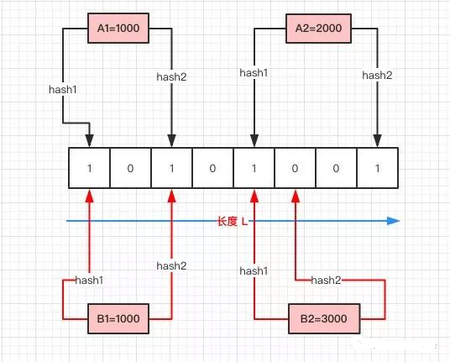
- 首先需要初始化一个二进制的数组,长度设为 L ,同时初始值全为0。
- 当写入一个 A1=1000 的数据时,需要进行 H 次 hash 函数的运算;与 HashMap 有点类似,通过算出 hashcode 与 L 取模后定位到0、2处,将该处的值设为1。
- A2=2000 也是同理计算后将4、7位置设为1。
- 当有一个 B1=1000 需要判断是否存在时,也是做两次 hash 运算,定位到0、2处,此时它们的值都为1,所以只能认为 B1=1000 可能存在于集合中。
- 当有一个 B2=3000 时,也是同理。第一次 Hash 定位到 index=4 时,数组中的值为1,所以再进行第二次 hash 运算,结果定位到 index=5 的值为0,所以认为 B2=3000 不存在于集合中。
三、特点
- 只要返回数据不存在,则肯定不存在。
- 返回“存在”时只能说明可能存在,仍可能误报;实际可信度还取决于查询数据分布。
- 不能清除其中的数据
- 其他条件不变时,增加位数通常可降低误报率
- 映射函数函数多浪费算力,一般取0.7*布隆位数/元素个数
四、设计方法
- 决定元素个数n和期望误差p
- 布隆位数为-n*ln(p) / ln(2)^2
- 哈希函数个数为0.7*m/n
- 为了保证低于期望误差,可以适当增加布隆位数